本文主要由艾特网能介绍算力服务器基础知识,英伟达GPU算力服务器基本参数、特点、应用场景等,并对算力服务器冷却系统的基本设计步骤进行总结。
01 算力应用领域背景知识
算力服务器是一种专门用于提供高性能计算能力的硬件设备,是支撑数字经济与智能计算的核心基础设施,在算力领域内也称为算力节点。算力服务器,一般采用“CPU+GPU/NPU/TPU/DPU” 的异构计算架构。除了基础的CPU外,它配置了更多的AI加速类芯片(如单机配置4卡或8卡),最常见的是GPU芯片,专门用于加速机器学习、大模型训练与推理等智能任务。作为对比,通用服务器一般基于多核CPU架构,主要用于处理日常的基础通用计算,如移动计算、物联网、企业日常办公(OA)、网页浏览等。
算力服务器中的GPU芯片对于算力性能具有至关重要的作用。GPU芯片国际品牌一般有NVIDIA(英伟达)、AMD(超威半导体),国产品牌有华为的昇腾(Ascend 950),寒武纪的思元(500),沐曦的曦云(C600)等。
常见的算力服务器主要是指配备了高性能GPU芯片/显卡的服务器,典型产品有英伟达(自产DGX平台)服务器;超微(Super Micro)、戴尔、惠普等厂家的OEM产品,他们提供配备英伟达GPU芯片的服务器,也提供配备AMD芯片的产品;国内服务器厂家有曙光、华为、浪潮、联想、宁畅等,他们提供英伟达GPU服务器,或其他国产GPU芯片的服务器。
算力项目的规模,除了按服务器的功率或机柜数量来要求外,也有按照“千卡”或“千P”要求的,前者指GPU显卡/芯片的数量,后者指算力服务器浮点运算能力。其中,服务器卡的数量易于统计,实际计算单台服务器的GPU显卡数乘以服务器数量即可。关于算力P数的概念,一般指的是GPU每秒的浮点运算能力,单位是xxx Flops,目前的GPU算力都很高,一般都是1012Flops量级,简写为TFlops,或1015Flops,简写为PFlops。算力与数据单元精度有关系,精度高时算力会降低,精度低时算力会升高,这个差别采用FP字母后面加存储数位来做区分,例如FP8就是采用8位来存储数据,称为8位精度;FP16就是采用16位存储数据,称为半精度;FP32就是采用32位来存储数据,称为单精度等。例如单颗H200 GPU芯片,FP16精度(训练场景)时算力是2.25P,在FP4精度(推理场景)时算力是 20P,FP8精度时算力是10P,8卡服务器的算力可以按照单GPU算力乘以8。
一般人工智能领域算力服务器有两种典型应用,模型训练和模型推理。前者指算力大模型如“豆包”、“千问”等训练(可理解为模型制作)过程,对算力及数据精度要求极高,一般是互联网巨头如国内的字节、阿里、腾讯等公司等会有大模型训练需求,可能需要万卡或万P的算力规模,精度一般使用FP8或者FP16。后者是使用以上大模型获得结果的(即用户端的应用)过程,对于算力及精度要求相对较低,但是对于服务器的响应时效性要求较高,一般使用FP4或FP8精度即可。目前英伟达的B300系列新芯片,对于低精度算力有优化,就是为了适应今后的大规模推理市场需求。另外注意,对于同样的GPU服务器,其同精度算力也有稀疏和稠密算力之分,算力P数略有差异,因此不同资料可能存在不同,并不一定是错误或偏差。
由于英伟达算力芯片公开技术资料最多,本文主要介绍英伟达GPU芯片/算力服务器的相关应用。
02 英伟达算力服务器分类
英伟达算力服务器按平台主要分为两大形态:一是基于 HGX 参考设计的标准化服务器,由各大服务器厂商(如戴尔、超微等)生产,成本相对略低,但设计相对灵活;二是英伟达自有品牌的 DGX 系统,如 DGX H100的8卡风冷服务器,内部集成硬件+软件,开箱即用且配置豪华,但成本较高。
英伟达算力服务器按散热模式划分为纯风冷服务器、冷板式直接液冷服务器(DLC)两种。风冷服务器就是整个服务器只配备散热风扇,所有器件都采用空气冷却。风冷8卡服务器高度一般有6U、8U、10U,主要是预留足够的冷却空气运行空间。目前风冷服务器一般单机柜布置2~4台,单机柜负荷不超过50kW。冷板液冷服务器,一般将铜质冷板贴合在服务器GPU、CPU等核心器件上,通过冷却液带走热量;部分液冷服务器仍需配置风冷系统辅助散热。液冷8卡服务器高度一般有1U、4U、6U形式,由于约70%以上的热量都被冷却液带走,故风冷散热比例显著降低,服务器的高度也随之降低,单台机柜内也可以布放更多的服务器数量。目前英伟达H系列、B系列8卡液冷服务器风液比接近1.5:8.5。英伟达最新的鲁宾(Rubin)系列架构,服务器采用100%冷板液冷方式,即不再需要风侧补冷。
英伟达算力服务器按芯片形式可以分为单芯片或者融合芯片两种。如H200或B200单芯片,一般单台服务器配置8张GPU卡,每张GPU显卡对应于1个GPU芯片。例如HGX形式的8卡服务器。部分服务器也有少量的NVL4版本,也就是4卡版本,但应用相对较少。第二种是超级芯片形式,如GB200或GB300超级芯片组,一个超级芯片由1个Grace CPU芯片配合2个B200或B300 GPU芯片组成。早期GB200融合芯片有HGX的8卡风冷形式,目前应用相对比较少。超级芯片更多的是以GB200 NVL72的超级算力节点形式提供,单机柜配置18个算力节点,每个算力节点包括2个CPU芯片和4个GPU芯片,单柜共72个GPU芯片。该超级算力节点的单位是整台机柜,采用冷板液冷冷却形式,柜内还包含PSU+Busbar的供电模块、Manifold、盲插快接、交换机、通信电缆等模块,一般由台达、超微等OEM厂家整柜提供,现场实施时再配套提供不锈钢环管、冷源、配电母线、CDU等。该超级算力机柜一般不做自行设计,整机采购应用,其单柜的价格在数百万美元(含服务器)。
03 英伟达主流GPU芯片规格
3.1 英伟达主流GPU芯片架构
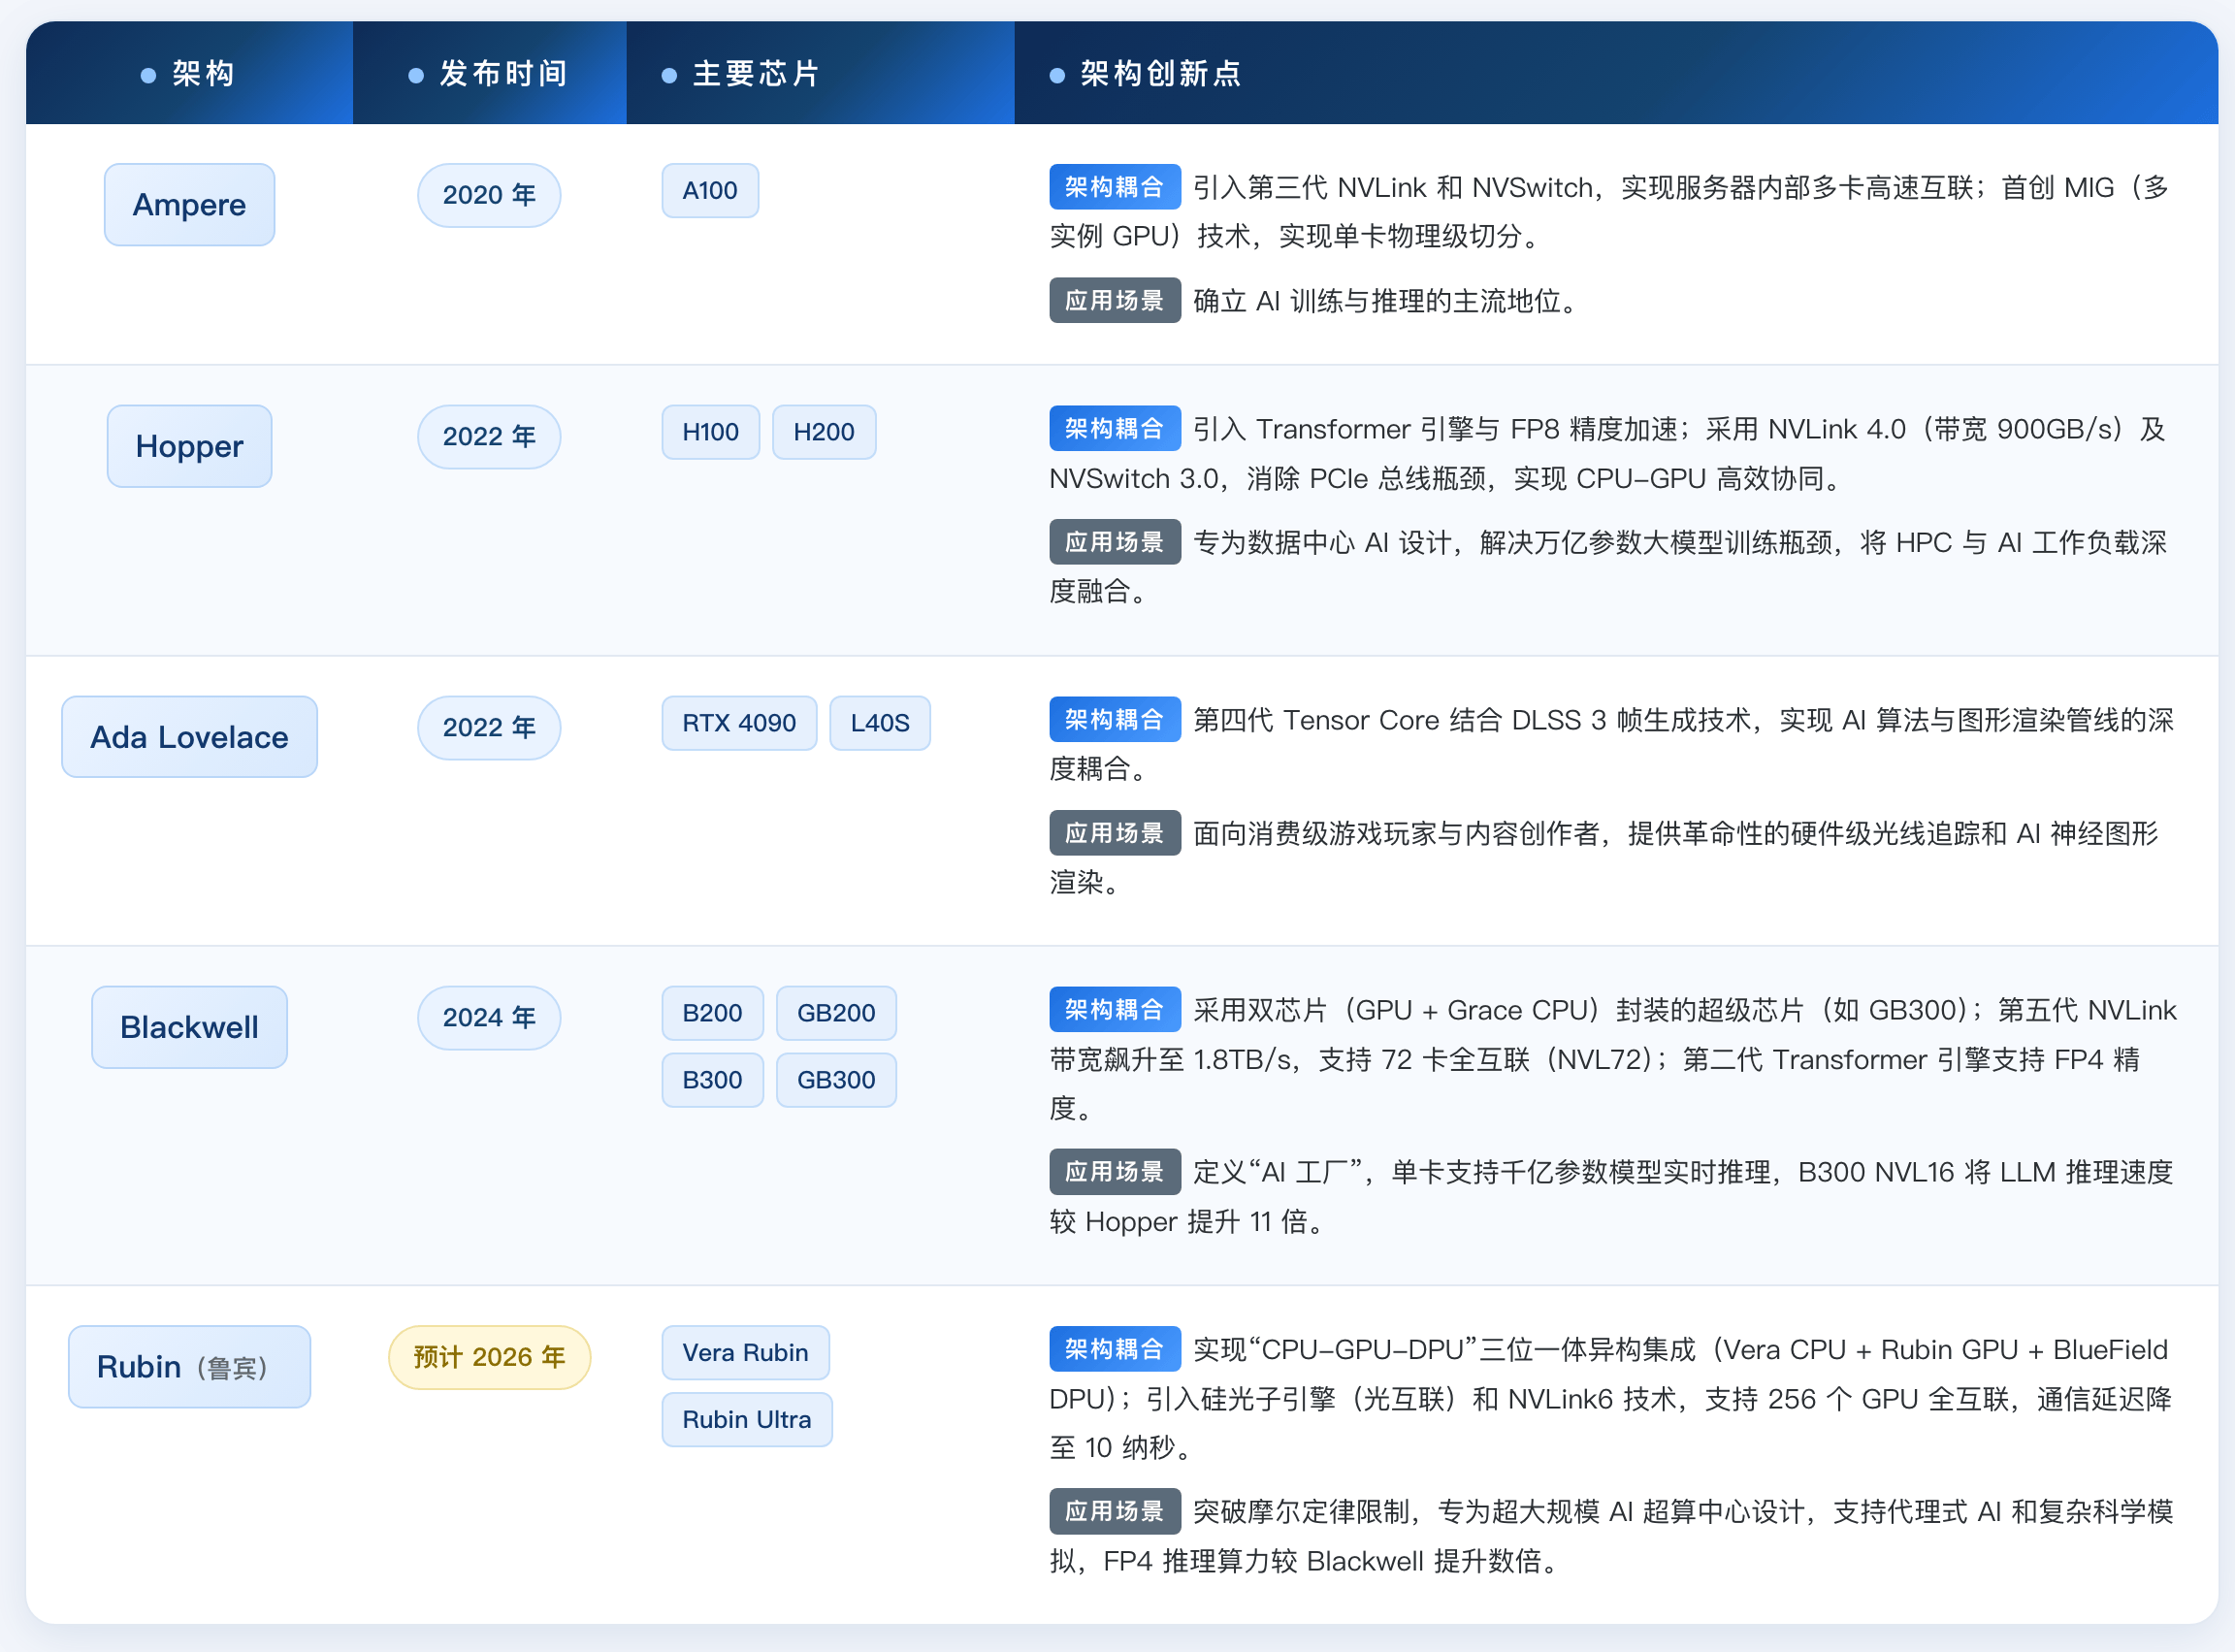
英伟达GPU芯片一般采用知名科学家名字命名,近几代产品如下:
表格 1 英伟达主流芯片规格及特点
3.2 英伟达主流GPU服务器参数
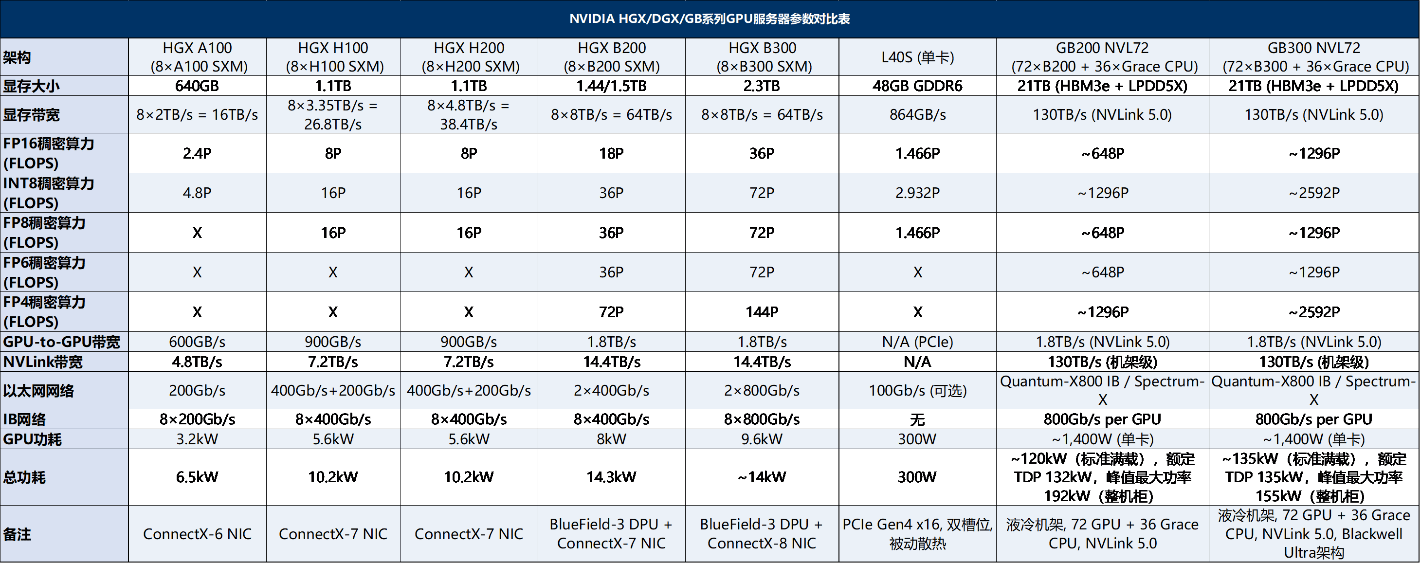
英伟达近几代主流GPU服务器参数信息如下:
表格 2 英伟达主流GPU技术参数
3.3 英伟达算力服务器组网方案
由于当前大模型的参数规模非常大(百亿以上),大模型训练时往往需要多张GPU卡组网工作。英伟达GPU组网形式一般分为两种,机柜内部采用NVLink协议高速互联(也称为Scale Up),机柜之间通过IB或网络协议互联(也称为Scale Out)。以GB300NVL72超级算力集群来说,单台机柜内部共有72张B300 算力卡,通过铜缆直接连接到NV Switch交换机芯片通信,机柜内部无需经过CPU,单GPU点对点带宽1.8TB/s,通信延迟在百ns。如单个集群配置多台(例如16台)GB300NVL72超级算力柜。各机柜之间通过光模块采用网络协议互联,中间需要通过2级交换机,单GPU点对点带宽800GB/s,延迟为1~2μs,几乎是柜内延迟的10倍。为了满足机柜之间所有GPU卡无阻塞通信,需要配备接近100台144口的800G网络交换机。算力服务器布局时,更倾向于优先采用柜内Scale Up组网,在此基础上再做Scale Out组网,这也是超级算力柜内节点卡数、功率快速增长的一个原因。因此在做算力服务器机柜规划时,一定要预留网络交换机柜,否则多台服务器之间无法组网运行!
3.4 两款典型英伟达GPU服务器介绍
3.4.1 英伟达H200系列8卡服务器参数
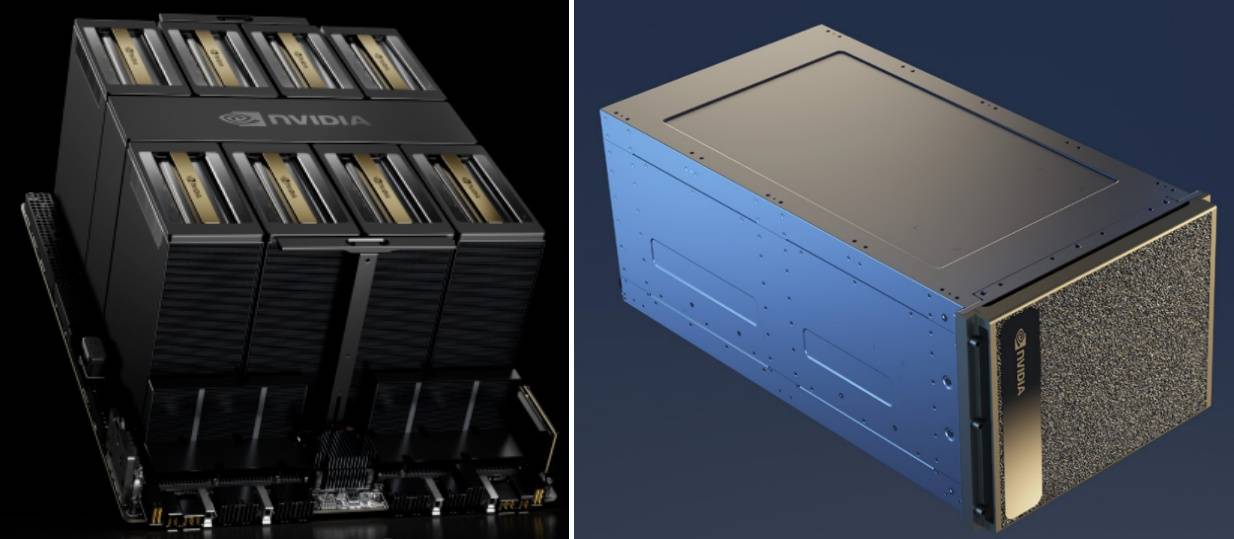
图 1 英伟达 DGX H200风冷服务器
基本参数如下,在做服务器冷却配套时,需参考如下参数选择机柜的尺寸、承重等规格,选择电源供电形式、柜内PDU规格等,单台机柜内服务器的布局数量,空调的送风温度等。对于液冷服务器,可参考服务器的冷却液接管规格,冷却液温度要求,服务器风液比设置等。
表格 3 英伟达DGX H200 风冷8卡服务器物理参数
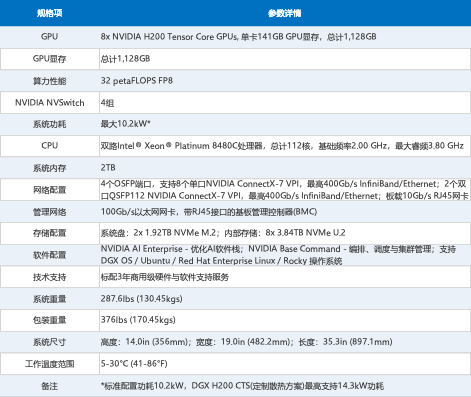
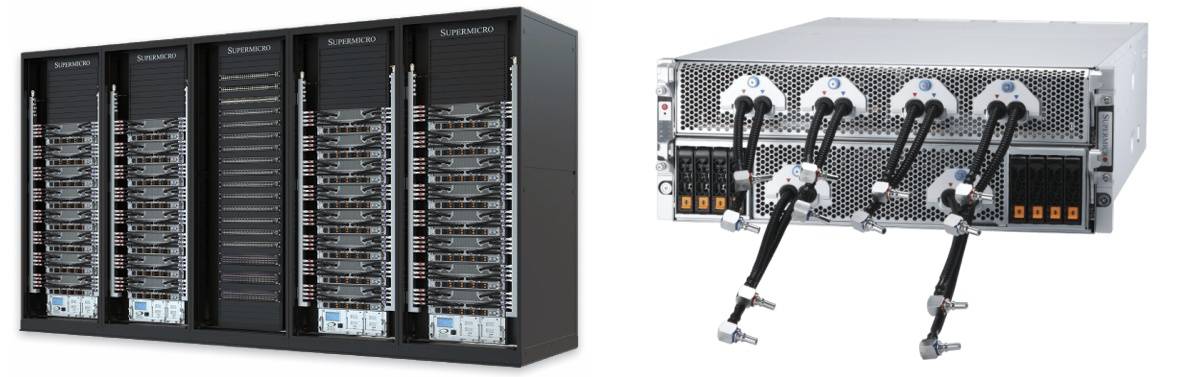
图 2 超微HGX H200 液冷8卡服务器图片
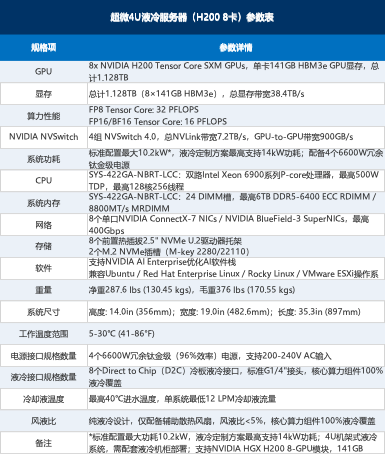
超微HGX H200液冷8卡服务器基本参数如下:
表格 4 超微HGX H200液冷8卡服务器
3.4.2 同规格GPU服务器不同冷却方式对比:
表格 5 B200 8卡风冷服务器、液冷服务器参数对比

注:因H200芯片风液服务器功率等差别不大,本表对比B200服务器
04 算力服务器冷却系统配套设计说明
4.1 算力服务器技术方案设计步骤
算力服务器制冷系统设计时,需要根据算力任务需求确定服务器/GPU卡数量,进而确定算力服务器形式和数量,从而根据算力服务器的负荷结合现场的实际情况配套设计。通过如下的步骤逐步确定关键信息:
· 算力规模
根据算力需求P数或卡数,结合算力服务器特点大致确定服务器总数。
· 服务器冷却形式
如算力规模较小,可选择风冷服务器,单机柜布置不超过3~4台,单机柜不超过50kW;如算力规模较大,可选择液冷服务器,单机柜可布置10台以内,目前单柜不超过150kW;如选择超级算力柜则可直接参考整柜规格进行配置,超级算力柜的单柜功耗随芯片规格、方案设计处于逐步增长的趋势,目前行业可达600kW左右,为全液冷设计。
· 冷负荷计算
根据服务器形式再次核算服务器数量,确定服务器总冷负荷。
· IT机柜布局
结合机房布局、单柜服务器数量完成机房室内IT机柜布局,需结合总GPU数量确定组网拓扑,进而确定网络柜布局。
· 制冷方案设计流程
结合IT机柜布局,服务器冷却形式综合确定制冷方案,一般风冷形式的算力服务器采用近端制冷形式,可采用水系统或风系统方案。
液冷服务器常规采用冷板液冷方案,根据机柜布局确定每个模块液冷负荷及二次侧管道布局,进而确定CDU规格、数量,如需补冷时,同步计算补冷空调规格、数量;结合总散热量即可确定室外散热设备规格,再整体规划室外一次侧管道及设备布局,从而完全确定IT部分制冷方案。室外散冷源采用高温风冷磁悬浮冷机、闭式塔或干冷器。
根据IT负荷规模也同步可以确定供配电系统设备规格,进一步完成辅助区空调方案配置。
4.2典型应用场景算力服务器配套设计
4.2.1 场景 1:中小推理集群(H100/H200 风冷,单机柜 40kW)
· 服务器:HGX H100 8卡风冷服务器,4台/柜;
· 冷却:列间空调/背板风墙近端制冷,全套冷热通道封闭组件(冷通道天窗、机柜盲板、热通道封板),制冷形式采用水系统或风系统;
· 机柜:标准 42U算力机柜,前后高通风率网门;
· 配电:100A三相智能PDU,1000A铜排母线或精密列头柜。
4.2.2 场景 2:中型训练集群(B200冷板液冷,单机柜64kW)
· 服务器:HGX 8卡B200冷板式液冷单机,4台/柜;
· 冷却:中高温CDU液冷系统,配套GPU微通道冷板、快接头、机柜歧管;配套远端大风墙形式补冷,室外冷源采用风冷磁悬浮冷机、干冷器或闭式冷却塔;
· 机柜:加强承重液冷专用机柜,内置管路支架、漏液报警;
· 配电:160A大电流铜排PDU,1600A母线槽或大容量精密列头柜。
4.2.3 场景 3:万卡超大规模训练集群(GB200 NVL72整机柜液冷,132kW/柜)
· 服务器:英伟达一体化GB200整机柜72卡液冷托盘,原厂一体化宽体液冷机柜形式提供;
· 冷却:集中式 CDU 液冷系统,远端大风墙形式补冷;室外冷源采用风冷磁悬浮冷机、干冷器或闭式冷却塔;
· 机柜:原厂一体化宽体液冷机柜;
· 配电:单机柜排配置4根母线供电,机柜内部PSU供电,2N或N+2冗余,机柜内置直流母排;380/480伏交流供电,远期规划 800VDC高压直流配电预留。
总结
本文主要由艾特网能介绍算力服务器的基础知识,英伟达主流GPU算力服务器的规格、架构、参数等内容,并且结合以上内容整理了算力服务器制冷系统设计的基本步骤。(作者:数字橙)
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。